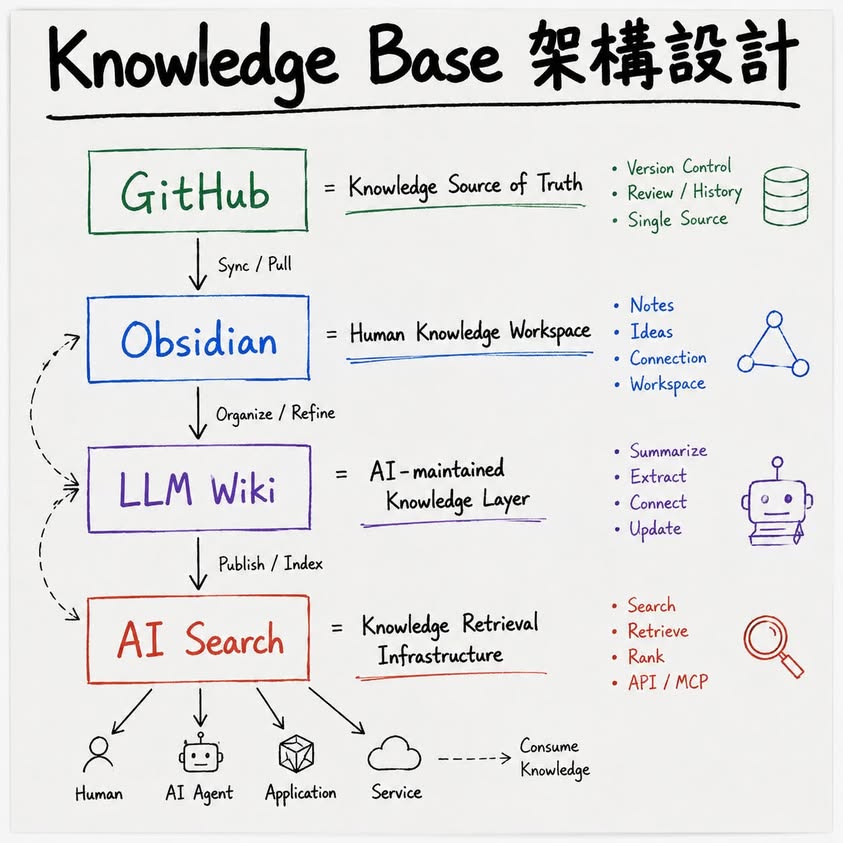
AI Search as a Service 如何架構在 Knowledge Base 上?
Cloudflare 新推出的 AI Search 生態我看了一輪,最值得注意的是 Cloudflare 把 Knowledge Retrieval 做成服務。AI Search 拉進企業 Knowledge Base 架構設計後,可以把元件拆成:
- GitHub = Knowledge Source of Truth
- Obsidian = Human Knowledge Workspace
- LLM WIKI = AI-Maintained Knowledge Layer
- AI Search = Knowledge Retrieval Infrastructure
這四層責任清楚:GitHub 管正式知識;Obsidian 給人整理筆記;LLM WIKI 讓 AI 整理與更新;AI Search 則負責把正確內容找出來。
這四個觀念我認爲是現代 KB 設計金礦
研究 Cloudflare AI Search 的架構後:
- 資料來源跟搜尋層分開。 資料可以留在 GitHub、Google Drive、Notion;搜尋層做 ingestion、parsing、chunking、indexing。「資料在哪」和「AI 怎麼找」務必分開。
- 搜尋不能只有 vector search。 API 名稱、錯誤碼、SKU、版本號只靠 embedding 不一定好找,所以需要 BM25、hybrid search 與 reranking 等等。
- Knowledge 不只給人看,也要給 Agent 用。 新的 KB 除了 UI,也需要 Search API / MCP,讓 Agent 直接
search()並取得來源。 - Knowledge 要有邊界。 用 Namespace / Instance 把部門、產品或客戶資料切開,不要全部塞進同一個 index。
照這個方向做,就可以把企業 KB 拆成:
Data Sources → Ingestion → Knowledge Layer → Indexing → AI Search → API / MCP → Human / Agent / Application
前面收資料與同步,中間保存 Source of Truth、AI 整理後的 WIKI 與搜尋索引,最後搜尋層負責檢索。最上面再補一個 Control Panel,管理資料來源、同步、權限與搜尋品質。
企業真正會問的是:誰負責、哪些 Agent 可以讀、哪些內容過期。
Cloudflare AI Search 最值得參考的,是把 Retrieval 變成 Infrastructure。未來做 Knowledge Base,不只問「用哪套 WIKI」,還要問 Source of Truth 在哪、人在哪整理、AI 怎麼維護,最後怎麼把 Knowledge 「同步」提供給 Human、Agent、Application。