Format 就是 Performance:資料怎麼擺,往往比程式碼怎麼寫更重要。
最近看到一個很有趣的壓縮格式 welcome-to-the-sunny-side/misa77。它沒有把重點放在更聰明的解壓縮演算法,而是重新設計整個資料格式。它把 Control Data 與 Literal Data 分開排列,讓解壓縮可以用更規律的方式讀取資料,搭配固定大小的記憶體 copy,減少解壓縮過程中的分支與判斷。
它讓壓縮變慢,只為了讓解壓縮變快。原因是壓縮通常只做一次,解壓縮可能會做成千上萬次。所以它把成本留在 Producer,讓 Consumer 每一次讀取都更便宜。
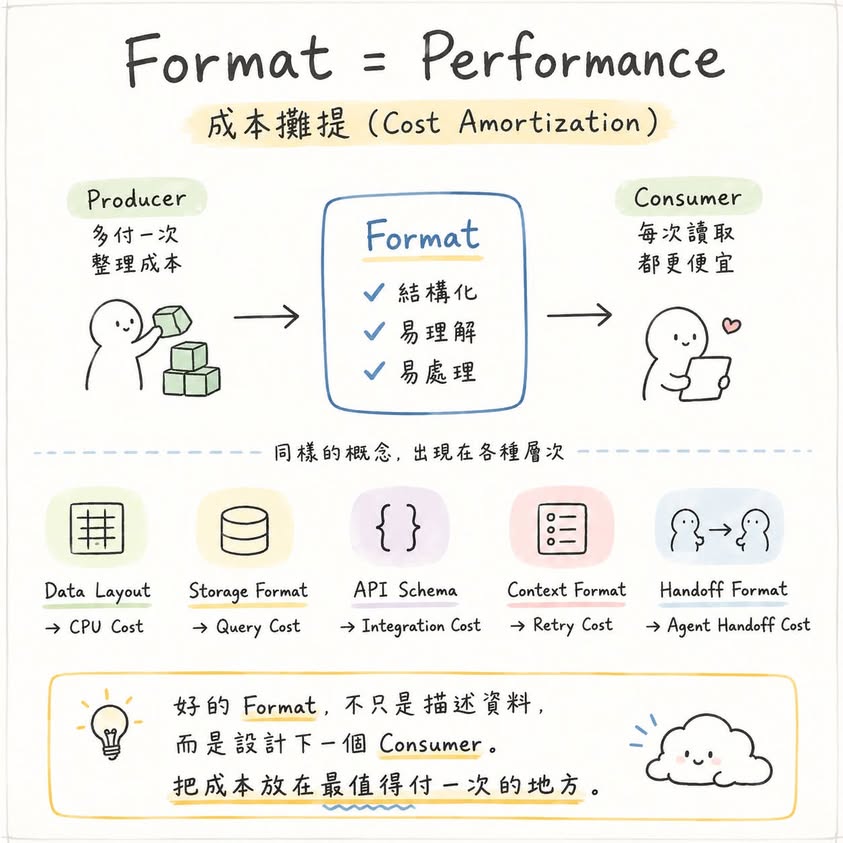
Format 的價值,其實來自「成本攤提」。你願意在寫入時多付一次成本,換取後面每一次讀取都省下一點成本。
工程師談 Performance,通常先想到少一次 allocation、增加 caching、平行化,或換更快的演算法。但很多瓶頸不一定在運算,而是資料一開始怎麼擺。這就是 Data Layout / Data Locality。
《Cache-Conscious Structure Definition》早就證明,即使不改演算法,只調整資料結構的排列方式,也能降低 cache miss 並提升效能。因為 CPU 真正花時間的,不一定是在算。很多時候,是在等資料。
所以好的 format,不只是把資料存起來。而是在重新分配 Producer 與 Consumer 之間的成本。
同樣的概念放到 AI Agent,也很有趣
同樣數量的 token,不管 context 排得好不好,模型需要執行的運算量可能差不多。真正的差異是:模型能不能正確判斷哪些是目標、哪些是限制、哪些是目前狀態。
很多人遇到 Agent 表現不好,第一個反應是繼續修改 Prompt。
- Prompt A
- Prompt A + B
- Prompt A + B + C
一直增加規則、背景與範例。但問題不一定是模型不夠強,也不一定是 Prompt 不夠長。可能是 Context Format 很差。
如果把 Goal、Constraints、Tools、歷史紀錄、輸出格式與驗收標準全部混在一起,模型雖然都看得到,可能更容易漏掉限制、誤判狀態,或重複執行已經完成的工作。
同樣的資訊,如果一開始固定整理成:
- Goal
- Current State
- Constraints
- Available Tools
- Output Schema
- Acceptance Criteria
模型沒有換,單次執行的 FLOPs 也不一定變少。但 Agent 更容易沿著正確的路徑執行。真正省下來的,是判斷失誤之後產生的重試、返工與額外 Token。
這就是我一直推廣的:提高 First-pass Acceptance Rate。
Long Running Task 的 Handoff,也是同一件事
如果一個 Task 執行四個小時後,只留下完整對話紀錄,下一個 Agent 就必須重新閱讀幾萬個 Token,再自行推測目前做到哪裡。過程中很容易重做已經完成的項目、忽略尚未驗證的結果,甚至延續上一個 Agent 已經證明錯誤的方向。
但如果上一個 Agent 額外整理成:
- Goal
- Completed
- Current State
- Validation Result
- Next Action
下一個 Agent 就不需要從完整歷史中重新推理整個狀態。上一個 Agent 多付一次整理成本。後面的 Agent 則能減少重讀 Context、錯誤接手與重新執行的成本。
Structured Outputs 與 Tool Calling 也是類似的概念。它們不會讓模型變得更聰明,而是讓下游系統不必一直猜格式、修格式、處理 Parser Failure,再重新 Retry。
但固定 Schema 也不是永遠更好。它會增加維護成本,也可能讓不符合模板的任務變得僵化。Schema 適合約束最終輸出,不代表所有中間思考都應該被塞進固定格式。
Format,是在設計下一個 Consumer
- Data Layout → CPU Cost
- Storage Format → Query Cost
- API Schema → Integration Cost
- Context Format → Retry Cost
- Handoff Format → Agent Handoff Cost
Performance,不一定來自更快的演算法。很多時候 Producer 先付出一次整理成本,避免 Consumer 重複判斷、重複解析與重複犯錯。
Format,不只是描述資料。
Format,是在設計下一個 Consumer。
好的 Format,會把成本放在最值得付一次的地方。